当 AI 吃穿存储带宽:华为云把计算网络变成了传输通道¶
元信息:论文 Fast Cloud Storage for AI Jobs via Grouped I/O API with Transparent Read/Write Optimizations,上海交大 IPADS + 华为云(Yingyi Hao、Ting Yao、Xingda Wei 等),FAST '26 正式论文集 pp. 255–270(USENIX 页面)。系统名 AITURBO,已在华为云生产部署(训练作业检查点读写,向推理与 agent 负载扩展中)。精读方式:主会话通读全文 + Agent 精读交叉核对(报告见 references/aiturbo-report.md)。阅读日期 2026-10-11。
AI 负载正在吃穿分离式云存储的带宽。训练侧,周期性 checkpoint 写是数百 GB 级的倾泻;推理侧,弹性扩缩容要读 checkpoint、agent 工作流要读共享前缀的 KVCache。华为云的观察(厂商口径):AI 任务已占本地数据中心云存储带宽的 10% 以上。
补带宽有两条路,论文把两条都堵死给你看。花钱扩 backend 带宽:把每节点带宽从 1.6 GBps 提到 80 GBps,每 GB 成本涨 16 倍(Figure 1(c))——云厂商要按比例 provisioning 更多存储服务器,而且集群网络天然优先保障 XPU 之间的通信(compute fabric 200 Gbps/XPU),而不是计算与存储之间的通道(storage fabric 100 Gbps/节点)。应用自己优化:Megatron 作为头部训练框架,用了约四分之一个代码库做 checkpoint I/O 优化,性能仍不最优——因为它看不到云存储的分离式架构(§1)。
FAST '26 的这篇论文给出第三条路:AITURBO。核心主张一句话——让存储层看见「整组」I/O,它就能透明做出优于应用层的优化。
一、两条洞察¶
洞察一:AI 集群里躺着的闲置资源,就是补带宽的通道。 host DRAM 和加速器之间的计算网络(200 Gbps/XPU),在存储 I/O 发生时基本闲置。拿它们当 staging buffer,在 XPU 和存储服务器之间中转数据,就能补上 storage fabric 的带宽缺口。这个观察其他工作也提过,AITURBO 的论证是它在 AI 集群里普遍成立:集群按负载分专区部署,推荐类服务的 DRAM 是满的,但训练专区用同一套硬件时 DRAM 就是闲的——闲与不闲按专区而分,正好可以按专区设计(§1)。当然,用 DRAM 当缓冲是拿持久性换性能:写到缓冲即可继续计算,等持久化完成再进下一迭代,丢了靠副本或上一版 checkpoint 兜底。这对 checkpoint 这类可重写数据是合理交易,对通用存储不是。
洞察二:AI 负载的 I/O 天然「成组」,而单条 read/write API 把这个信息丢掉了。 训练时全体 XPU 组成一个组同步写同一份 checkpoint(参数按 XPU 分片,去重后冗余可观,论文 Table 1 按不同 DP/ZeRO 配置做了去重率分析);推理弹性扩容时多个新 job 同时读同一个模型文件;agent 场景下同前缀任务并发读同段 KVCache(论文用真实 agent trace 分析,Figure 6:存在成组的 KVCache 读,可一份共享、不必按 XPU 数成比例增加存储读)。既然 I/O 是成组发生的,API 就应该让应用声明「这一组客户端将一起参与这次 I/O」——group 语义让云存储看到完整的 I/O 模式,而存储提供商比应用开发者更懂底层的分离式架构,于是能透明推导出更优的去重与读写计划。
这两条洞察合成一个 API:group_putfile / group_getfile,比原来的 getfile/putfile 多一个 group= 参数,声明参与的客户端组;再配两个 future——future_0 表示数据已进 CPU DRAM 缓冲(XPU 可以继续计算了),future_1 表示数据已持久化到 backend(checkpoint 场景等它再进下一迭代)。如果 future_1 还没就绪就崩了,相关文件标记为 broken,AITURBO 靠在多台服务器的 DRAM 里复刻数据来尽量兜住(Gemini 式),保证 future_1 的操作要么全部完成、要么明确丢失(§3)。
二、写路径:去重、写缓冲、写回¶
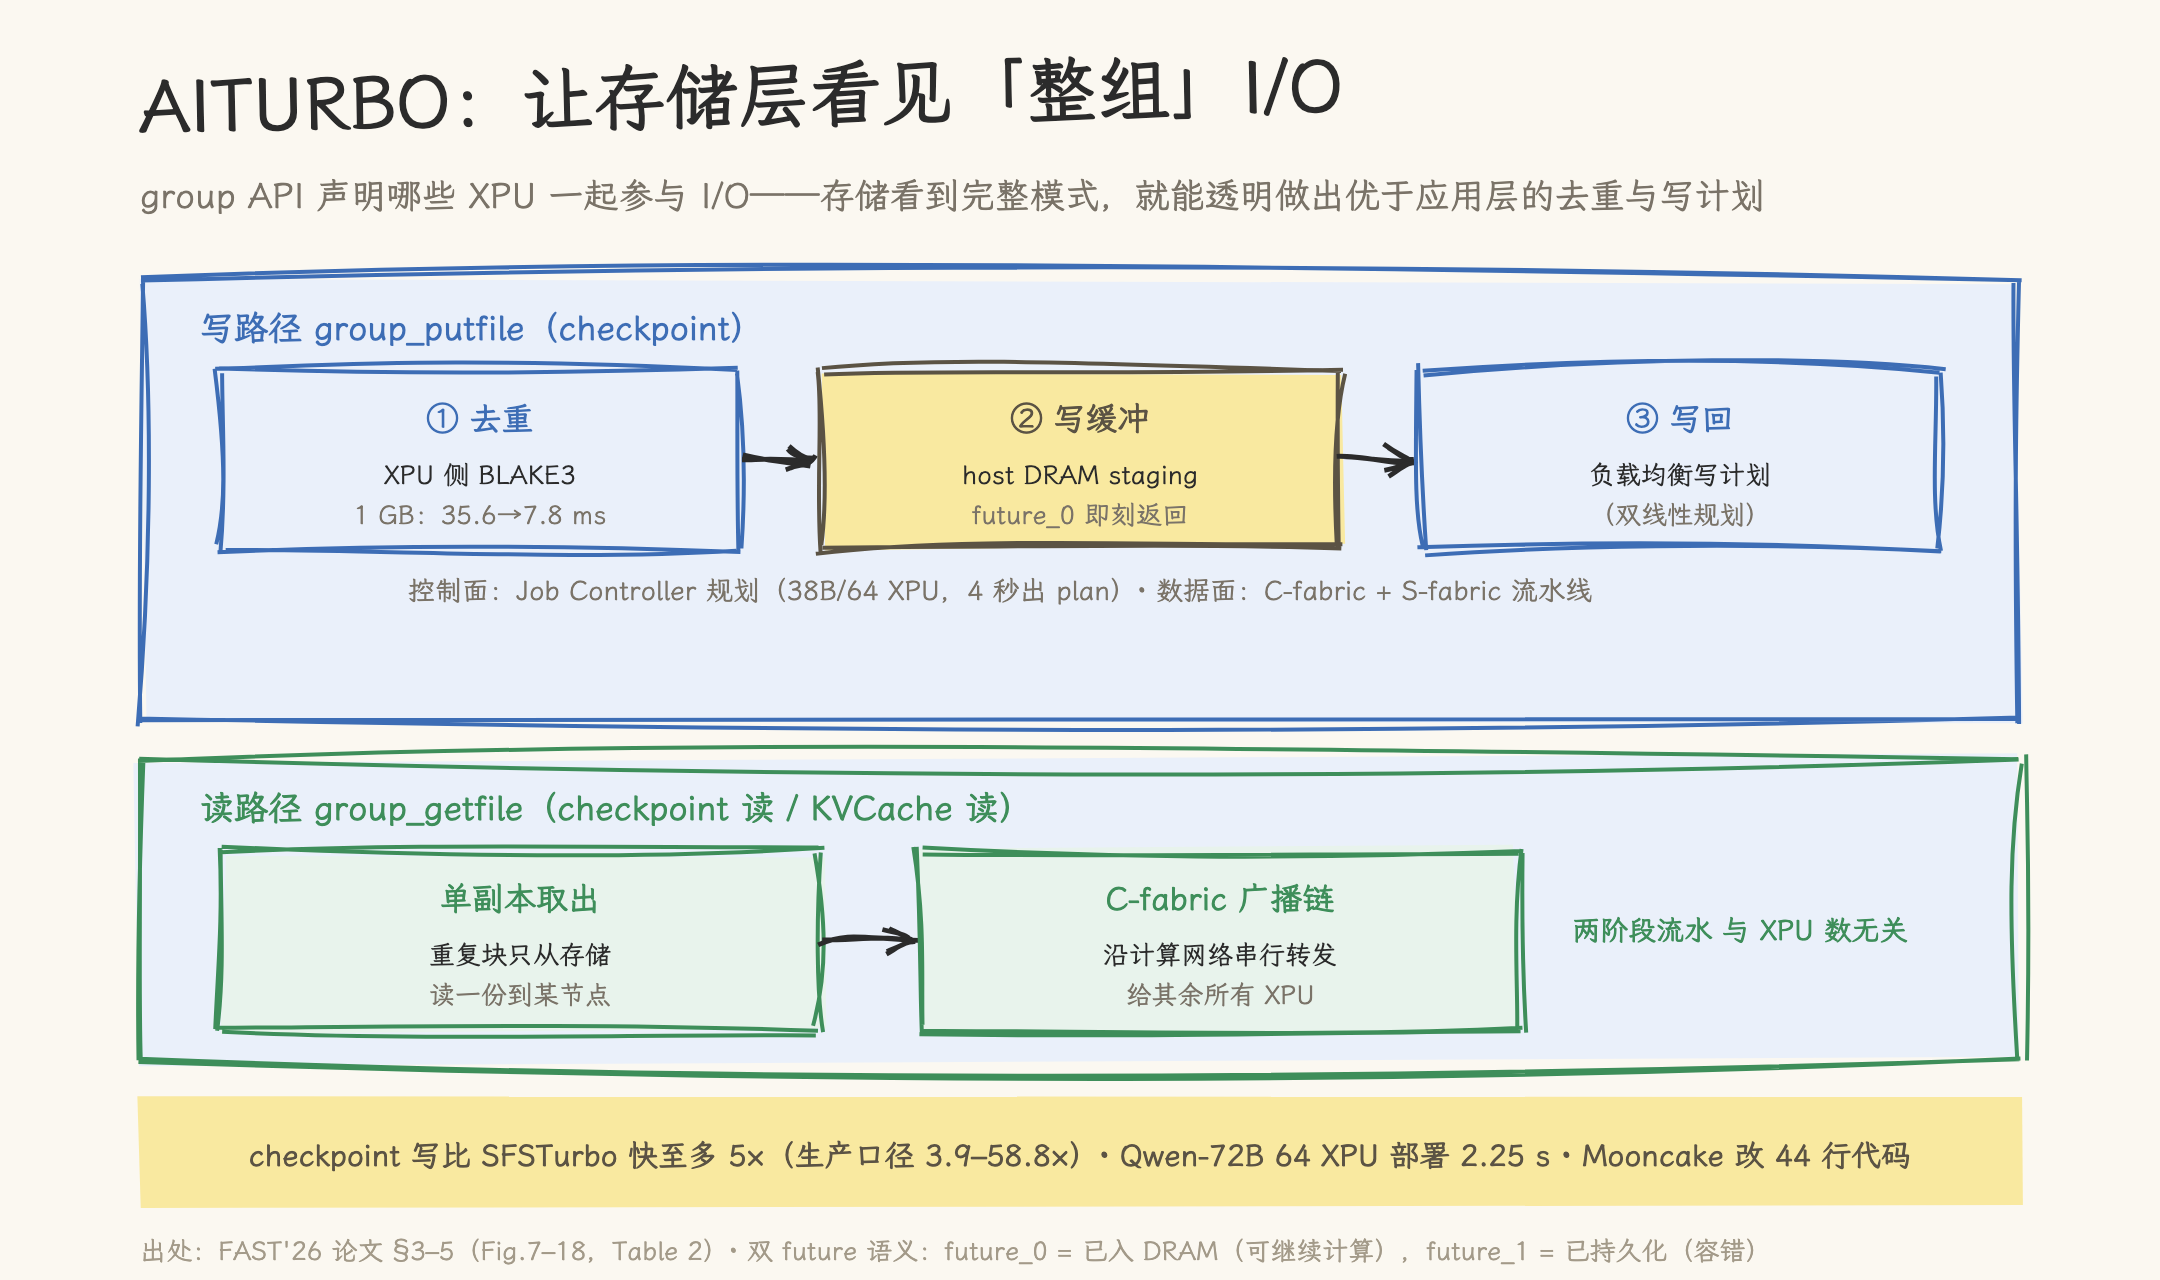
group 写在物理执行上分三步(§4.1,Fig.9)。
第一步,去重。 组内去重放在文件层:每个 XPU 对自己要写的文件算校验和(4 MB 块到整文件多种粒度,实践中偏好大粒度——减小找最优写计划的复杂度),校验和连同文件元数据(张量名)交给 job controller 识别重复块。算校验和本身用 XPU 侧优化过的 BLAKE3 内核:1 GB 文件从 CPU 的 35.6 ms 降到 XPU 的 7.8 ms。去重元数据按 job 生命周期缓存——模型参数不会每个 checkpoint 都变,后续写可以跳过重复的校验和计算。一个 corner case 论文也处理了:训练前几个迭代优化器状态全是零,会触发「假去重」,等 pattern 稳定后缓存写计划即可绕过。
第二步,写缓冲。 去重后的负载写入 host DRAM(跨服务器统一管理空闲 DRAM 的 staging buffer manager 负责),future_0 就地返回,训练继续。
第三步,写回。 把 DRAM 里的数据按「负载均衡写计划」写回存储服务器。计划怎么生成?论文把它形式化为一个双线性规划:目标是最小化端到端传输完成时间 t(不是带宽利用率——留点余量反而更好),7 条约束覆盖源出带宽、目的入带宽、节点间链路带宽、DRAM 容量、副本因子。双线性规划非凸难解,但论文注意到每个二次项的变量一个有清晰下界(payload 除以聚合带宽)、一个有上界(任意随机 plan),于是用那个经典套路:固定 t 做二分,每次归约成线性规划可行性问题求解。38B 模型、64 XPU 的场景,未优化的 Python 单线程实现 4 秒就能出 plan;plan 按 job 生命周期缓存复用(同一训练的各迭代写模式相同)。执行时 DRAM 到存储流水线化,chunk 进缓冲就立即转发。
三、读路径:取一份,广播链分发¶
group 读的思路更直接(§4.2)。批量读里重复的块(同模型被多个扩容 job 读、同前缀 KVCache 被多个 agent 读),只从存储取一份到某个节点,然后用计算网络做「串行转发链」广播给其余所有节点——论文说这类似 BlitzScale 的做法,两阶段流水。命中其他节点 DRAM 缓存的数据直接走计算网络取,不再碰存储。
配套的工程细节有一处很务实:自建点对点 QP 代替 NCCL 组通信——NCCL communicator 的冷启动是秒到分钟级,自建 QP 建链只要 15 ms,还能与存储初始化重叠(§4.3)。
四、评估:数字与工程账¶
测试床是 Ascend 910B(64 GB HBM)与 A800(80 GB)两套集群、至多 64 XPU,每节点 192 核 / 1.5 TB DRAM。基线:Megatron+SFSTurbo(华为通用云存储)、Megatron+Gemini(作者在 Megatron 上复刻其技术)、ServerlessLLM(checkpoint 读)、Mooncake(KVCache 读)。
- checkpoint 写(Figure 13):六种配置(1.5B/13B/38B × 有无 ZeRO)下,AITURBO 比 Megatron+SFSTurbo 快至多 5×,Gemini 关闭去重的配置下再快至多 5.9×;生产环境口径为比 SFSTurbo 快 3.9–58.8×。因子分解:去重贡献 4.3–47.2%,写计划再降至多 76%。
- checkpoint 读(Figure 17):存储带宽瓶颈下(30 Gbps 摊到 XPU),所有系统读 135 GB 的 Qwen-72B 都要 173 秒;但单副本进 DRAM 后,AITURBO 在 64 XPU 上 2.25 秒完成部署,且时间几乎与 XPU 数无关——ServerlessLLM 同场景要 1384 秒。
- KVCache 读(Figure 18):Qwen-14B + 真实 trace 重放 30 分钟,Mean TTFT 从 0.8 ms 降到 0.65 ms(−23%)。
- 工程账(Table 2):Megatron 自研 checkpoint 优化 2228 行代码,换 AITURBO 只改 286 行;Mooncake 只改 44 行。group 协调开销在 64 XPU 下最大 45 ms。
五、边界:四个要在意的地方¶
其一,前提绑定。 收益依赖「计算网络有富余 + host DRAM 闲置」,论文自己承认推荐类业务的 DRAM 是满的;通信密集负载(如大规模 MoE all-to-all)与存储借用带宽竞争时,最低优先级 QoS 下的实际可用带宽,论文没有刻画。迁移到其他厂商的硬件口径(非 Ascend/RoCE/SFSTurbo 栈)需要自行复核。
其二,持久性换性能。 future_0/future_1 语义本质是把 DRAM 副本当一等公民,DRAM 副本全失即丢数据——对 checkpoint 可接受(重写即可),对必须落盘的数据不成立。
其三,一个精读中值得标注的发现。 Mooncake 对比实验并未真正使用 group API(论文原话大意:同步运行中的推理实例太困难),只是替换了 cache miss 后的存储读路径——所以推理侧 23% 的 TTFT 改善并非来自组去重本身,引用这个数字时要注意归因。
其四,大块传输的边界。 只优化 XPU 间的大块传输,小块 I/O 不受益;按 job 生命周期缓存的写计划,在频繁扩缩容导致组成员变化时是否触发重计划、代价多大,论文未交代。
六、为什么这篇值得单独一篇文章¶
五篇 FAST'26 的 KV×存储论文里,AITURBO 的位置最「基础设施」:它不管 KV 的布局(SolidAttention)、不管复用的位置语义(CacheSlide)、不管调度与逐出(Bidaw)、不管页缓存策略(PPC/modelFS)——它只做一件事:把「这组 I/O 是一起发生的」这个信息从应用搬进存储层。信息一到位,去重、写计划、广播分发这些经典优化就自动变得比应用层做得好,因为存储提供商确实更懂自己的分离式架构。
对实践者的映射:如果你的 AI 集群也面临 checkpoint 写带宽焦虑,先问三个问题——host DRAM 有多少闲置、计算网络与存储网络的带宽差是多少、你的训练框架在 checkpoint I/O 上花了多少代码。三个答案分别是「不少、差很多、不少」,AITURBO 的路线就值得评估;开源实现在 openEuler 系生态可循,论文明确了对 Megatron 与 Mooncake 的接入只需数百行以内的改动。
论文结构索引¶
| 论文位置 | 内容 |
|---|---|
| §1 / Fig.1(c) | 带宽成本 16 倍、Megatron 1/4 代码库、生产口径 3.9–58.8× |
| §2 / Fig.3–6 | AI 负载 I/O 特征:Bulk I/O、异步重叠、成组 I/O;agent trace 的 KVCache 共享读 |
| §3 / Fig.7–8 | group API(group= 参数、双 future、broken file 语义)与三组件架构 |
| §4.1 / Fig.9–11 | 写路径:BLAKE3 去重(XPU 核算)、双线性规划写计划(式 1–7,固定 t 二分 + LP)、流水线 |
| §4.2–4.3 / Fig.12 | 读路径:单副本 + C-fabric 串行广播链;自建 QP 替代 NCCL |
| §5 / Fig.13–20 / Table 2 | 评估全量数字与工程账 |
| §6–7 | 讨论与结论(大块传输边界、QoS 隔离留待未来) |
参考资料¶
- Yingyi Hao et al., Fast Cloud Storage for AI Jobs via Grouped I/O API with Transparent Read/Write Optimizations, FAST '26, pp. 255–270. USENIX 页面
- 精读报告(Agent 交叉核对):references/aiturbo-report.md
- 系列关联:五场景总纲 · 可编程页缓存单篇 · Mooncake 架构详解