Agent 的 KV 为什么复用不了:位置一漂移,前缀缓存就失效¶
元信息:论文 CacheSlide: Unlocking Cross Position-Aware KV Cache Reuse for Accelerating LLM Serving,上海交大(Yang Liu、Yunfei Gu 共同一作等)+ 浪潮济南 + 北大 + 华为云,FAST '26 正式论文集 pp. 83–99,带 Artifact Evaluated–Available 徽章,开源于 github.com/SJTU-Storage-Lab/CacheSlide。精读方式:Agent 精读 + 主会话全文通读交叉核对(报告见 references/cacheslide-report.md)。阅读日期 2026-10-11。
智能体工作流正在成为推理负载的新形态,它给 KV Cache 复用出了一道新题。多轮对话里前缀缓存很好使——System prompt 和历史轮次原样重复,前缀匹配命中即可复用。但智能体的 prompt 不是这样长的:每一轮都是「系统提示 + 任务更新 + 阶段产出」的动态拼接,里面有大段内容相同却位置不同的文本。前缀缓存对它们无能为力——位置一变,整段 KV 就成了「新的」。
CacheSlide 把这道题形式化成 RPDC(Relative-Position-Dependent Caching)——论文自述这项形式化「advances the state of the art in this emerging area」——并给出一个有意思的答案:与其在复用后修补位置,不如换一种位置编码,让漂移从一开始就不影响相似度。全文实现扩展 vLLM 0.8.5,结论:延迟降 3.11–4.3×、吞吐升 3.5–5.8×、SSD 写放大降 3.11–3.62×(§7)。
一、三类 prompt 范式与 RPDC 模式¶
论文先对主流智能体的 prompt 做结构化抽象(§2):System prompt + Updated prompt + Fixed prompt 三段式,并归纳三类范式——CoT 型(Reflexion、Self-Refine:更新段是逐步累积的推理记录)、记忆型(MemGPT:工作缓冲区经 memory API 修改、FIFO 后缀不变)、工具增强型(SWE-Agent/AutoGen:函数规格动态注入、历史消息在后缀累积)。基于 GitHub 日志分析与实验(Figure 3),各 agent 输入中可复用片段占比都很高,但方差也大(0.010–0.080)——更新段长度不可预测。
RPDC 的正式定义(§3.3):一类 KV 复用场景,上下文由多段组成,可复用段的相对顺序必须保持(任意重排会带来实质性退化),而可复用段之间的夹层内容持续更新。此时既需要保序(PDC 的约束),又需要容忍位移(PIC 的灵活性)。
二、双输分析与一条量化证据¶
PDC(前缀复用:ContextCache、PromptCache、vLLM APC/SGLang radix cache)只许在预定位置复用。论文用两条论据证明「重排换位」不可行:其一,prompt 头部天然吸引更多注意力(attention sink),MemGPT 特意把工作窗口放头部——换位即破坏注意力分布;其二,SWE-Agent 的更新槽与不变段之间有运行时数据依赖(更新槽的产出是不变段的入参),重排破坏程序语义。
PIC(位置无关复用:CacheBlend、EPIC)把复用段位置清零,但这制造了 PMKD(§3.2.1 定义:同一文本因位置编码不同导致的 KV 相似度偏差),只能靠预选 token 重算补救——而多头注意力各头关注的 token 不同、输出要到 decode 期才融合,「prefill 期预选无法保证稳定精度」(§3.1.2)。
量化证据是 CKSim 实验(§3.2,Figure 4a):CKSim 定义为逐头 K/V 余弦相似度均值,用 MemGPT + ShareGPT 构造 MemHistory 负载——位移 0→1000 时,RoPE 的 CKSim 下降超过 90%,CoPE 类位置不敏感编码仅降约 28%。另一个佐证:window padding(预留 1K/2K/3K 空位)在多轮推理后 F1 比基线低 78% 以上(Figure 4b)。由此得出核心观察(§3.3):保住相对顺序 + 低位置敏感编码,固定段内部与固定段之间的注意力可以 near-lossless 复用,只有固定段与更新段之间的跨注意力需要小规模重算。
顺带的系统层发现(§3.1.3):主流框架(vLLM/SGLang/TensorRT-LLM)的 KV 读写逐层串行,形成层内 load-before-write 锁无法重叠;LRU 淘汰不感知脏页,部分更新的页被驱逐带来随机写放大。
三、三组件设计¶
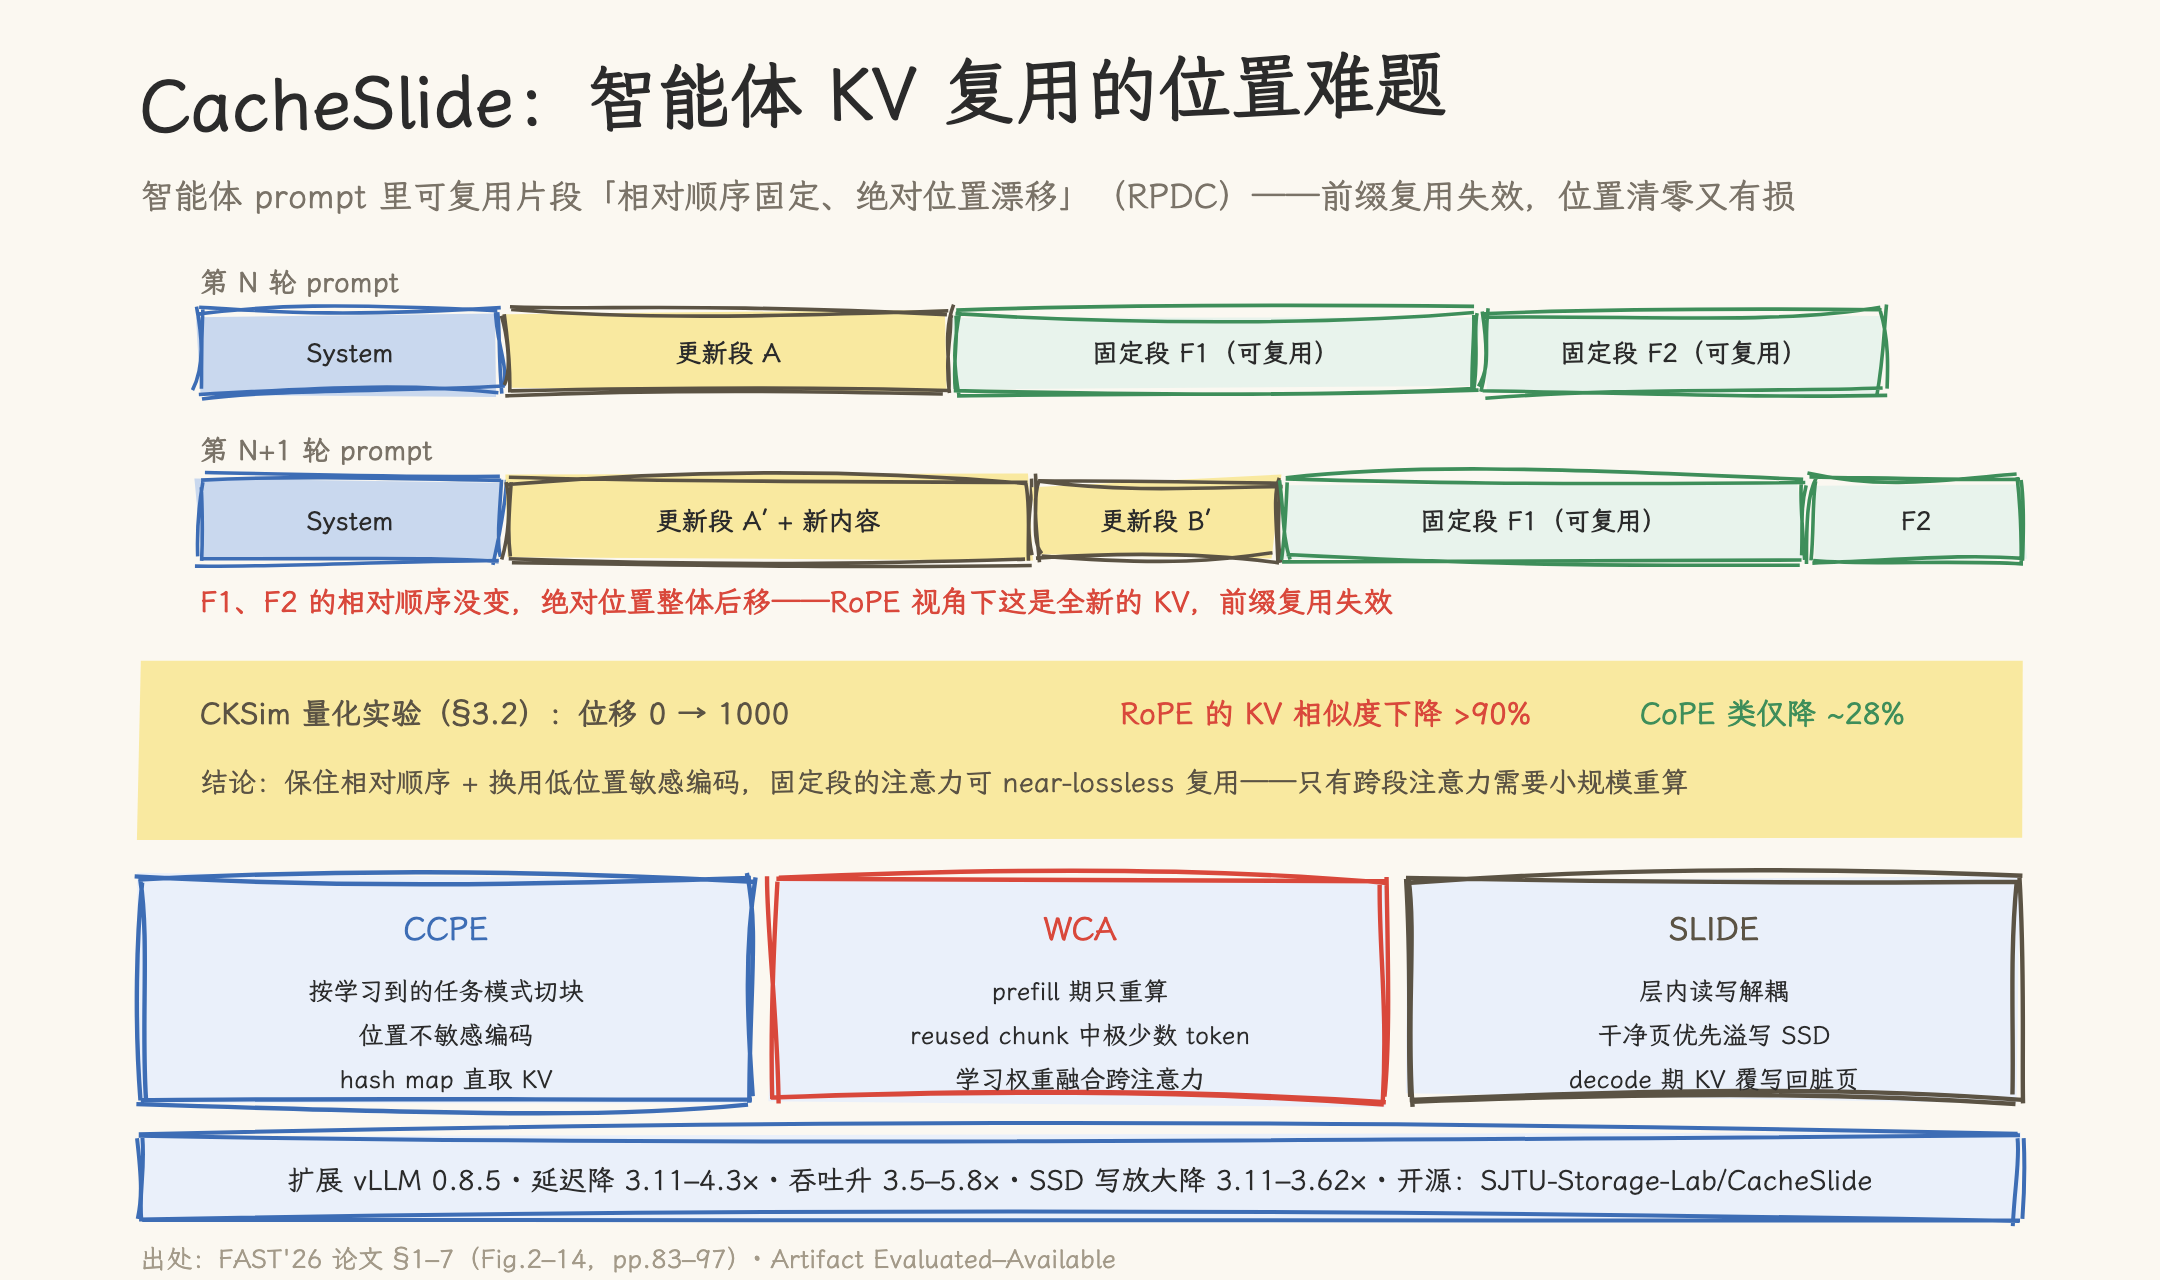
CCPE(Chunked Contextual Position Encoding,§4.2,Algorithm 1)。 位置编码选 CoPE(相邻 token 共享位置索引,对位置漂移天然不敏感)。关键机制是「预训练 + 推理」两段:预训练阶段对一类任务用 CoPE 编码全部 prompt,以直方图统计找出最高频(Apox 最小)的编码模式;推理时按任务模板把新 prompt 分成 K 个 chunk,标记 reused/recompute——reused chunk 经 hash map 直接取缓存的 KV。缓存位置与推理实际位置的 Apox 偏差被压到可忽略(论文例子:缓存位置 10–20,实际推理 9–21 或 10–10)。重训问题的答案在这里:CoPE 支持通过 adapter-based continued pretraining 获得(在 attention 上加 LoRA adapters 学习,保留全部 backbone 权重),且是 dual-style 设计——激活 CoPE 即 CacheSlide 行为,禁用则完全恢复原 RoPE/ALiBi 行为(§5 开头)。也就是说:需要一次 LoRA 级别的继续预训练,但不动 backbone,可随时切回。
WCA(Weighted Correction Attention,§4.3,Algorithm 2)。 负责恢复跨段注意力。三步:Layer 1 对整个 prompt 全量重算(建立基准);收集缓存 KV 与重算 KV 有偏差的 token 索引集合 S,按偏差降序取 top-k;Layer 2 起每层只重算 S 中的 token,用按偏差计算的权重 α 融合新旧 KV,并每 4 层做一次 CKSim 门控——某 token 的 CKSim 已低于阈值 τ 就从重算集合中移除。两个超参的稳健值:top-k ≈ 0.12(重算 12% 的 token)、τ ≈ 0.26(Figure 14 heatmap 跨数据集/模型一致)。对比先验方案:CacheBlend 重算约 18%、EPIC 每分段首尾共 64 token——CacheSlide 把重算量与精度稳定性同时优化了。原理支撑:注意力稀疏性源自机制本身,层间表示随深度增大更相似,所以只重算约 26% 的 KV token 足以保质量,且越深的模型效果越好。
SLIDE(§4.4)。 存储侧管三件事:预分配额外 KV 页并维护 per-request BlockTable/slot_mapping,实现层内 load-write 解耦(消除 §3.1.3 的层内串行锁);重定位 WCA 选中的 token 到新页;脏页管理——从 Layer 2 起,含 selected token 的页标记脏并维护计数,溢写时先溢写干净页,脏页按 selected-token 计数降序逐出,合并覆写成顺序写回、降低写放大(WAF)。实现直接落在 vLLM 0.8.5 的 PagedAttention 结构上。
四、评估:Pareto frontier 与逐项消融¶
实验设置(§5.1):vLLM 0.8.5,A100 80 GB(70B 模型双 A100 + 500 GB DRAM + 2 TB NVMe PCIe Gen4),Ubuntu 20.04 / CUDA 12.6;数据集 HotPotQA(Reflexion)、WikiChat Multi-Session Chat(MemGPT,约 1 万多轮对话)、SWE-Agent-Bench(Python 测试修复);模型 Mistral-7B、MPT-30B、Llama-3-70B(CoPE 经 LoRA 继续预训练,backbone 不动);基线 ContextCache(Kimi 上下文缓存的复现)、PromptCache、CacheBlend(重算 18%)、EPIC(每分段首尾 64 token);指标 TTFT / Success Rate / Rouge-L / F1。
精度–TTFT 权衡(§5.2,Figure 10):三模型三数据集上,CacheSlide 稳定落在 Pareto frontier——对比 ContextCache,TTFT 降 2.4–3.3× 且精度损失可忽略;对比 CacheBlend,TTFT 再降 1.21–2.11×;对比 PromptCache,TTFT 降 1.97–2.88× 且 accuracy 提升 1.41–3.95×。极快系统(EPIC/PromptCache/ContextCache)有实质性精度损失,高精度系统(Recompute/PromptCache)TTFT 差——CacheSlide 是唯一两头占住的。
并行推理与 beam search(§5.3,Figure 11):batch 2/4/6 与 beam 2/4/6 下,CacheSlide 的 TTFT 增幅始终最小(batch 2 时 1.2× 到 batch 6 时 2.1×;beam 同趋势),对比基线 PromptCache 存储足迹最重、CacheBlend 溢写后性能劣化。
SLIDE 消融(§5.4,Figure 12):层间加载-写解耦(LWD)降低层间 KV 加载延迟 26.7–51.5%;SLIDE 消除写停顿 66.9–73.5%(对比 CacheBlend);batch 4→16 时写放大降低 3.11–3.62×;GPU 存储占用较 PromptCache 降 1.63–1.9×。
吞吐稳定性(Figure 13):平均吞吐比 CacheBlend/EPIC 高 63.1%,而标准差低 68.9%——Reflexion+HotPotQA 上高 49.6%/45.2% 且 σ 降 77.4–58.6%;MPT-30B 上高 75.82%/52.1% 且 σ 降 75.84–64.1%。「快且稳」来自脏页逐出消掉了随机盘 I/O。
超参敏感性(§5.5,Figure 14):top-k ≈ 0.26、CKSim 阈值 ≈ 0.12 处 QPS 一致性峰值;原理是注意力稀疏性内生于机制——约 26% 的 KV token 重算足以保质量,且层越深相似度越高,门控会自适应少算。
五、边界¶
三个需要留意的边界。其一,「切块基于学习到的任务模式」需要 LoRA 级别的继续预训练来学 CoPE 适配器——backbone 不动、可 dual-style 切换,工程代价可控,但「即插即用零适配」不成立,新任务类别需要重新预训练直方图。其二,RPDC 之外的收益不明:纯前缀重复场景 vLLM APC 零重算已近最优,真乱序插入(RAG 多文档任意排列)不满足「相对顺序固定」前提,论文未测。其三,精度评估用的是 Success Rate/Rouge-L/F1 这类任务级指标,LongBench 式逐 token 一致性未测——「精度损失可忽略」的粒度是任务级。
六、生态关联¶
放进 KV 复用的谱系:位置固定(PDC:Kimi Context Cache、PromptCache、vLLM APC、SGLang radix cache)→ 位置无关(PIC:CacheBlend、EPIC,选择性重算恢复)→ 相对位置保持(CacheSlide:改位置编码把漂移抹平),第三代把重算量从启发式压到 12% 并配上存储侧协同。与同会论文的分工:SolidAttention 压缩单请求 I/O(端侧),Bidaw 优化多用户分层调度(服务端),CacheSlide 消除复用的重算(智能体)——见系列总纲。与 LMCache/Mooncake 的分层存储属同一问题域的存储侧延伸(SLIDE 的 SSD 溢写与脏页管理与 LMCache 的 KV 下沉正交可叠加,精读员注)。
论文结构索引¶
| 论文位置 | 内容 |
|---|---|
| §2 / Fig.3 | 三类智能体 prompt 范式、可复用占比与方差测量 |
| §3.1–3.2 / Fig.2,4–5 | PDC/PIC 双输分析、PMKD 定义、CKSim 量化(RoPE >90% vs CoPE ~28%)、window padding 失败 |
| §3.3 | RPDC 正式定义与核心观察(保序 + 低位置敏感编码 → near-lossless 复用) |
| §4.1 / Fig.6 | 三组件工作流总览 |
| §4.2 / Alg.1 / Fig.7 | CCPE:CoPE 预训练直方图 + chunk 划分 + hash 复用(Apox 例证) |
| §4.3 / Alg.2 / Fig.8 | WCA:top-k 重算 + 偏差加权融合 + 每 4 层 CKSim 门控(top-k 0.12/τ 0.26) |
| §4.4 / Fig.9 | SLIDE:解耦、重定位、脏页标记与溢写策略(vLLM 0.8.5 实现) |
| §5 / Fig.10–14 | 评估:Pareto frontier、并行/beam、SLIDE 消融、吞吐稳定性、超参敏感性 |
| §6–7 | 相关工作(RPDC 形式化定位)与结论 |
参考资料¶
- Yang Liu, Yunfei Gu et al., CacheSlide: Unlocking Cross Position-Aware KV Cache Reuse for Accelerating LLM Serving, FAST '26, pp. 83–99. USENIX 页面
- 开源实现:github.com/SJTU-Storage-Lab/CacheSlide
- 精读报告(Agent 交叉核对):references/cacheslide-report.md
- 第三方解读(数字与本文互核一致):marsggbo 的论文解读——其「CoPE 适配器预训练可能损害基础模型泛化」「仅测三个 Agent 系统」两点批评,与本文 §五边界判断相同
- 系列关联:五场景总纲 · SolidAttention 单篇 · Bidaw 单篇 · AITURBO 单篇