128k 上下文塞进 16 GB 内存:FAST'26 把 KV Cache 拆碎了放 SSD¶
元信息:论文 SolidAttention: Low-Latency SSD-based Serving on Memory-Constrained PCs,上海交大 IPADS(Xinrui Zheng、Dong Kun Wei、Haibo Chen 等),FAST '26 正式论文集 pp. 67–82。精读方式:主会话全文通读 + Agent 精读交叉核对(报告见 references/solidattention-report.md)。阅读日期 2026-10-11。
在 AI PC(主打本地跑大模型的个人电脑,行业通行写法为分写的 AI PC)上本地跑大模型,最先爆的不是算力,是内存。论文开篇的算术:Llama-3.1-8B 用 INT4 量化,权重只要 8 GB,但 128k 上下文的 KV Cache 要超过 16 GB——是权重的 4 倍多(Figure 1a)。市售这类 PC 的内存是 8–16 GB,连 KV 都装不下。
把 KV 放 SSD 上是显然的出路,但直接搬会有一个尴尬的数字:加载 1k token 的 KV Cache(128 MB)需要约 40 ms,几乎占一个 decode step 的一半时间(§2.3)。SolidAttention(上海交大 IPADS)要解决的正是这个:内存受限的 PC 上,怎么让 SSD 上的稀疏注意力推理快起来。
一、根因:细粒度随机 I/O 撞上顺序读的 SSD¶
先看两组测量。
第一组:SSD 的随机读吞吐随传输单元急剧变化——从 2 KB 到 1024 KB,吞吐差出数倍(Figure 1b)。SSD 只在足够大的传输单元下才能吃满内部并行度(通道并行、die 级并行),小颗粒随机读是 SSD 最讨厌的形态。
第二组:FlexGen 这类 SSD offload 系统靠 zigzag 调度掩盖 I/O——把多个请求排成批,用别的请求的计算隐藏当前请求的 KV 加载(Figure 2 上)。这在数据中心成立,因为请求并发高;但在本地场景,batch=1、请求并发低,算不出可重叠的窗口,GPU 空转和 SSD 空转交替出现(Figure 2 下)——掩蔽失效,40 ms 直接裸露在延迟里。
再加上一层矛盾:动态稀疏注意力(如 InfLLM 按 block 选择 top-k 参与注意力、Quest 用 query-identifier 相似度)读 KV 是按块随机跳读的——细粒度随机 I/O 与 SSD 的粗粒度顺序偏好正面相撞。论文的判断是:这不是算法或存储谁的问题,是两者必须协同设计(§1)。
二、三个支撑观察¶
协同设计要有抓手,论文给了三个观察,每一个撑起一个设计组件。
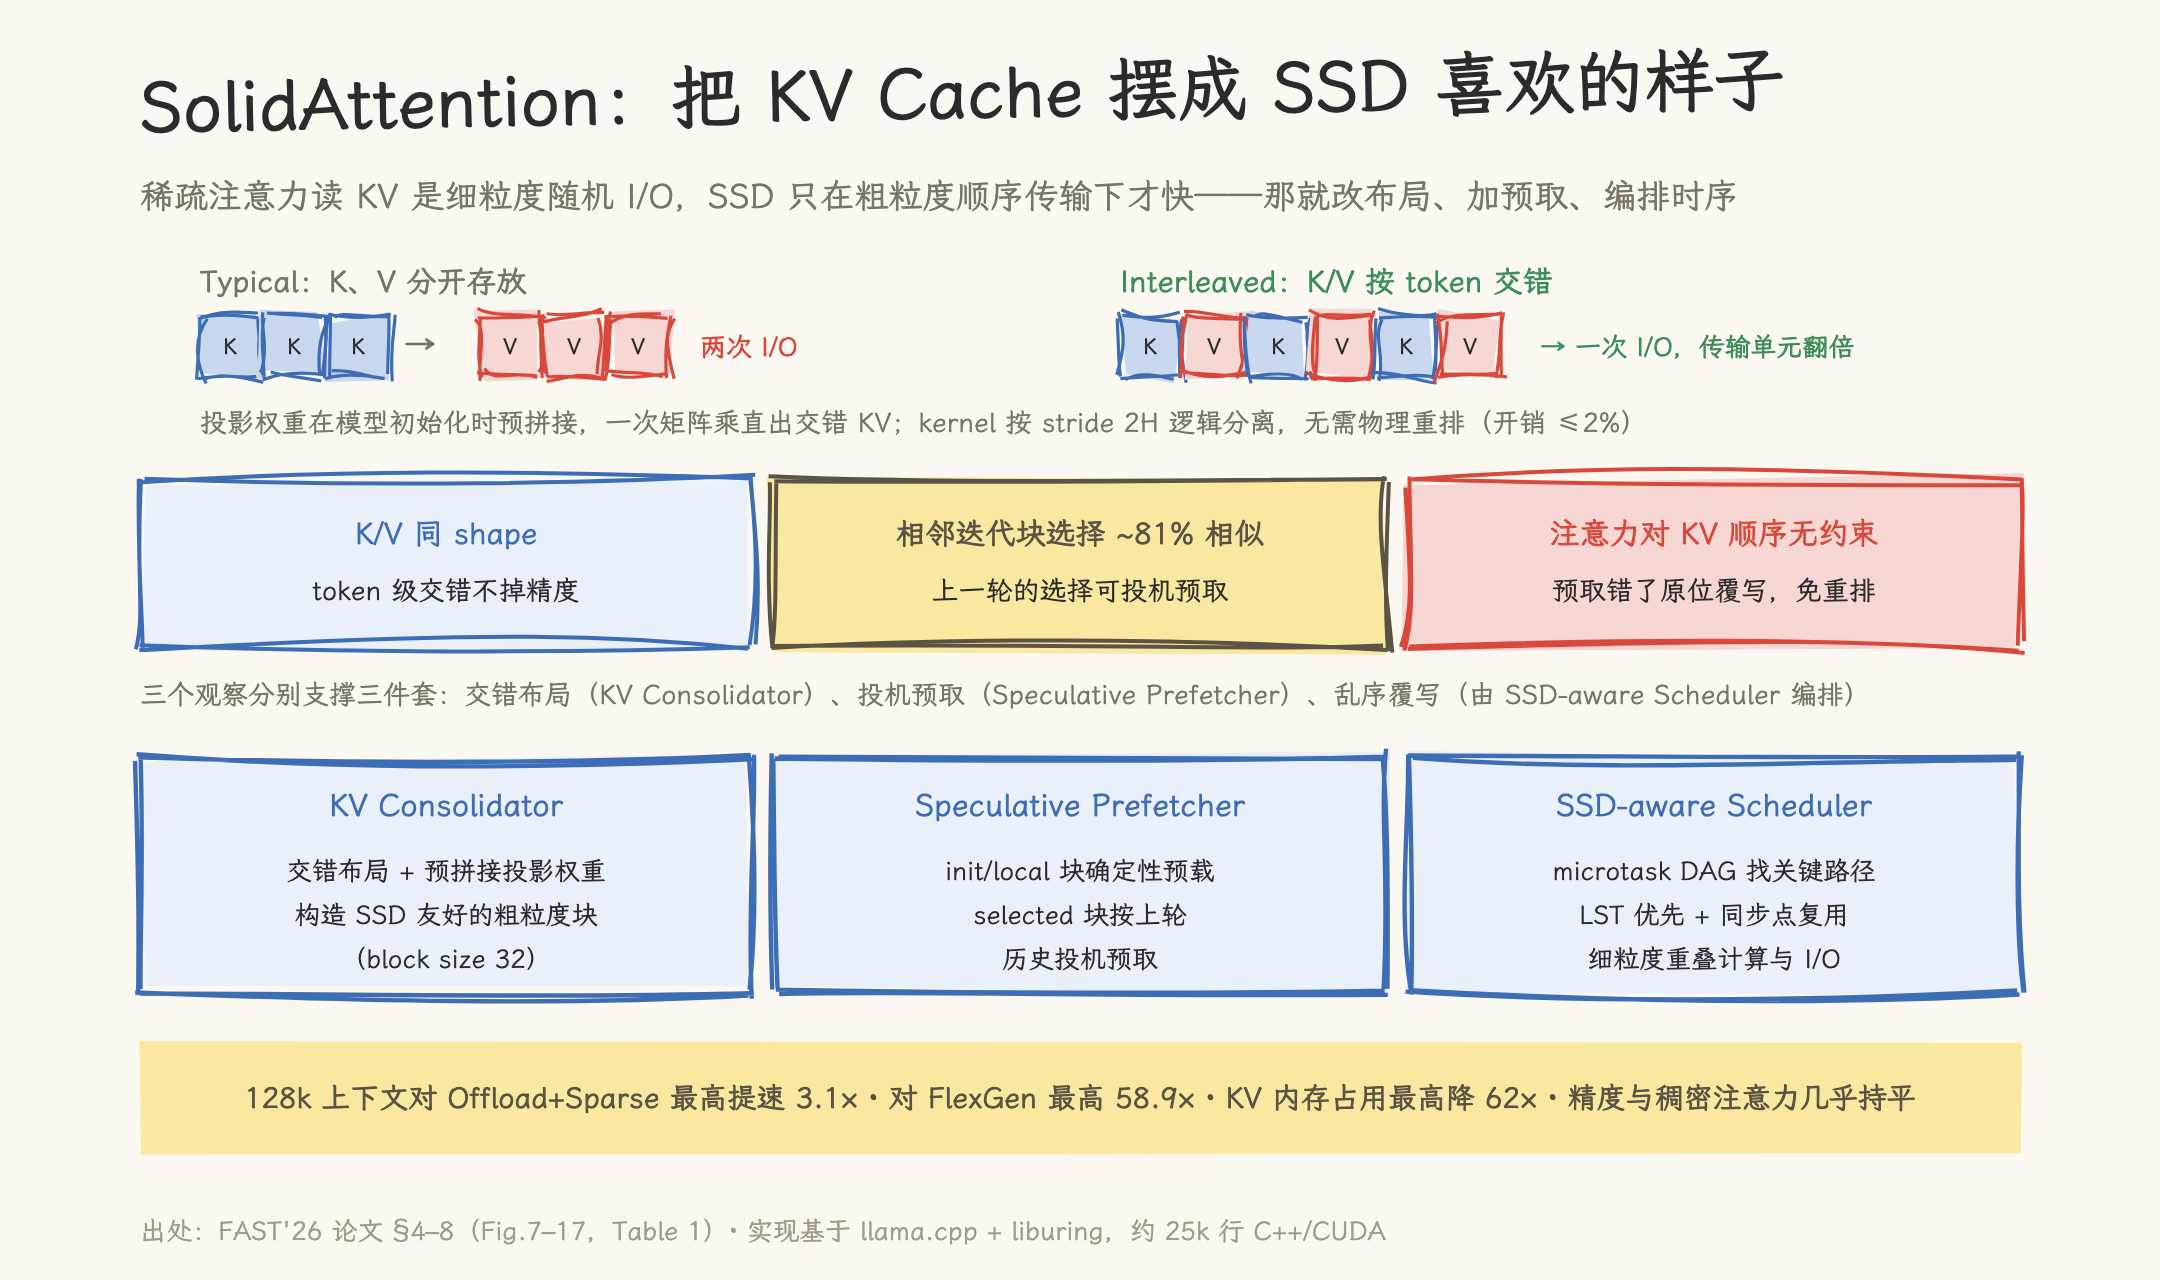
观察一:K 和 V 同 shape。 对每个 token,K 和 V 是同样形状的张量。那么可以按 token 粒度把 K/V 交错排列——传输单元翻倍、I/O 次数减半,而每块包含的 token 数不变、不掉精度(§4,Fig.7/8)。这避开了「压缩 token 换粒度」的老路:块越大精度越差,recall 随 block size 从 32 到 256 一路下滑(Figure 6)——交错是唯一不掉精度的合并方式。
观察二:相邻迭代的块选择约 81% 相似。 动态稀疏注意力每一层都要选块,但跨层看,LongBench 多模型多基准上相邻迭代的选择结果平均相似度约 81%(Figure 9,1k context budget)。上一轮选了什么,这一轮大概率还选——这就是投机预取的依据。
观察三:注意力对 KV pair 的全局顺序无约束。 自注意力只要求每个 token 的 K 和 V 对齐,KV 在缓存里的先后顺序是任意的。这条性质让投机预取的「错误」变得便宜:预取错的块不用搬走,直接被新块原位覆写即可,不用任何重排(§5.2)。
三、三件套设计¶
KV Consolidator(§4)。 负责把 KV 摆成交错布局。实现上有个巧思:交错输出如果按常规方式生成,需要两次投影矩阵乘再做重排;SolidAttention 在模型初始化时就把 K、V 投影权重预拼接成一个统一张量,一次矩阵乘直接产出交错的 KV pair,消除后处理。推理时 kernel 按固定 stride 2H(H 为隐藏维)从交错缓冲中逻辑分离 K 和 V,无需物理重排——实测开销 ≤2%,且 PyTorch、llama.cpp 等主流框架原生支持 strided 访问。
Speculative Prefetcher(§5)。 块分三类:init blocks(初始窗口)与 local blocks(滑动局部窗口)是确定性的,直接预载入;selected blocks(top-k 动态选择)按上一迭代的历史选择投机预取(Figure 10a)。预取利用注意力间隙的空闲 SSD 带宽,为后续自注意力备料。
SSD-aware Scheduler(§6)。 有了交错布局和投机预取,还需要编排:注意力模块被分解为 microtask(attention、q_proj、kv_proj、store、prefetch、select、load),建 DAG 找关键路径,非关键 I/O 尽早发起——比如 select 操作只依赖 q_proj,q_proj 一完成就发起,正好把缺失块的 load 延迟藏在并发的 kv_proj 计算里。多个 microtask 同时就绪时按 LST(最晚开始时间)优先调度,同步点合并复用。实现基于 llama.cpp + liburing,约 25k 行 C++/CUDA。
四、评估:两台笔记本上的数字¶
配置:Ultra 9 185H + RTX 4070 Laptop(8 GB)与 Ultra 7 255H + Arc 140T iGPU 两台机器,均 64 GB DDR5 + 1 TB Samsung 990 PRO(DRAM 限 16 GB);模型 Llama-3.1-8B / Llama-3.2-3B / Qwen-2.5-7B(权重 INT4、KV FP16),batch=1(§8.1)。
- 吞吐(§8.2,Fig.12/13):128k 输入对 Offload+Sparse(InfLLM)加速 2.8×/3.1×/2.4×(CUDA 三模型)、SYCL 最高 2.5×;对 FlexGen 最高 58.9×(16k 以上 FlexGen CUDA OOM)。
- 内存(Fig.14):KV Cache 内存占用最高降 61.9×/62.0×/61.9×;Qwen2.5-14B(SYCL)降 98%,128k 下仍比 Offload+Sparse 快 1.7×。
- 精度(Table 1):三模型平均分 57.67/65.93/70.76,对稠密原始 57.82/65.76/71.39 几乎持平;对照 KV INT4 量化的 54.70/62.31/18.63(Qwen 上崩溃)。
- 消融:预取降低阻塞延迟最高 CUDA 3.9×;K/V 交错降注意力延迟最高 22%;对比全内存 InDRAM+sparse 的吞吐损失 ≤11%(Fig.15)。
五、局限与边界¶
论文承认的:相对全内存方案有约 11% 的吞吐损失;14B 模型的 FFN 计算强度会稀释收益;小 KV 模型预取收益下降;KV 频繁写有写放大(§7 的 32 KB/层写缓冲是缓解手段)。
全本补充的评估(§8.4.3–8.7)把边界刻画得很细。消融:交错 KV 降 decode 注意力延迟(Fig.17a),SSD-aware Scheduler 的细粒度重叠较 naive 提升性能至 25%、attention 延迟降 22%(同步点复用贡献其中一部分);敏感性:context budget ≤4k 时 I/O 能被计算完全掩盖,超过 4k 出现陡增(§8.5.1)——「128k 也快」的前提是 budget 压在 1k,不是免费午餐;block size 32 比 16 高约 14% 吞吐(§8.5.2);SSD-high(990 PRO)与 SSD-low(BG6)在 4k budget 下差异 45%(§8.5.3)——盘越好收益越大。干扰(§8.6):背景 I/O 竞争下吞吐降 58%(4 GB/s 干扰)/54%(800k IOPS),尾延迟升 2.4×/2.9×——端到端可摊薄但裸指标敏感。能耗(§8.7,Table 2):3.68 vs 5.37 J/token,能耗改善 46%——SSD 换 GPU 计算的能耗账是正的。相关工作(§9)明确与 H2O/InfiniGen(KV 压缩)、AWQ(量化)、PowerInfer/FlashInfer/eMoE(offload)正交互补。结论重申 3.1× 与 98% 内存缩减。
精读标注(精读员注):81% 相似度意味着约五分之一的投机预取块仍需补读,若任务的块选择模式跨层漂移剧烈,预取会退化;Table 1 的 LongBench 单项普遍略降(如 Llama-3.2-3B 40.10→38.25),块级稀疏对需要全局精确注意力的任务本质有损;评估仅两台笔记本、单一 SSD 型号、batch=1;budget >4k 的陡增说明长上下文加大的场景(远超 128k)尚未覆盖。
六、生态关联:端侧路线与集群路线的分野¶
SolidAttention 与它的两个直接对照构成了一条清晰的传承线:FlexGen 的 SSD offload 思路被论证不适配 batch=1,InfLLM 的代表向量块选择与「sink + local」分类被继承(attention sink 即 StreamingLLM 的经典现象)。与 vLLM PagedAttention 同以「块」为单位管理 KV,但目的不同:PagedAttention 解显存碎片,SolidAttention 的块是 SSD 传输粒度。与 Mooncake/LMCache 方向相反:后者面向集群、以吞吐和复用为目标、依赖请求级并发——SolidAttention 证明的是,低并发端侧必须走「稀疏算法 × 存储粒度 × 调度时序」的协同设计路线。这个分野对端侧 KV 分层存储(比如 LMCache 的本地 tier)是有参照价值的设计约束。
在 FAST'26 的五篇 KV×存储论文里,它占据「AI PC 端侧 batch=1」象限,见系列总纲。
论文结构索引¶
| 论文位置 | 内容 |
|---|---|
| §1–2 / Fig.1–2 | 问题规模(128k KV 16 GB)、40 ms/decode、SSD 传输单元-吞吐关系、FlexGen 低并发失效 |
| §3 / Fig.3–5 | 三组件架构、块三分类(init/local/selected)、单层 dataflow 时间线 |
| §4 / Fig.6–8 | KV Consolidator:交错布局、预拼接权重、strided kernel ≤2% |
| §5 / Fig.9–10 | 投机预取:81% 相似、确定性 + 投机两类、乱序覆写 |
| §6 / Fig.11 / Alg.1 | microtask 分解、DAG 关键路径、LST 调度、同步点复用 |
| §7 | 实现:llama.cpp + liburing,25k 行;2 个专用核;32 KB/层写缓冲 |
| §8.1–8.4 / Fig.12–17a / Table 1 | 评估配置与主要数字(吞吐/内存/精度/消融) |
| §8.4.3–8.7 / Fig.17b–21 / Table 2 | 交错消融 22%、调度消融 25%、budget 4k 拐点、block size、SSD 配置 45%、干扰 −58%、能耗 −46% |
| §9–10 | 相关工作(与压缩/量化/offload 正交)与结论(3.1× / 98%) |
参考资料¶
- Xinrui Zheng et al., SolidAttention: Low-Latency SSD-based Serving on Memory-Constrained PCs, FAST '26, pp. 67–82. USENIX 页面
- 精读报告(Agent 交叉核对):references/solidattention-report.md
- 系列关联:五场景总纲 · 可编程页缓存单篇 · AITURBO 单篇